
本页内容

2024 年 8 月,我们用 TSBS 对比过 GreptimeDB 和 InfluxDB 的读写性能(GreptimeDB vs. InfluxDB 性能测试报告)。当时 InfluxDB 3.x 开源版本还没有就绪,测试对象是 InfluxDB v2,我们在文末提到会在 InfluxDB 3 就绪后重新测试。
这次的测试对象是 GreptimeDB v1.2.0 和 InfluxDB 3.11.1,InfluxDB 同时测了开源的 Core 和商业的 Enterprise 两个版本。3.11 的 Core 和 Enterprise 使用不同的存储格式:Core 继续使用 Apache Parquet;Enterprise 的新建集群默认使用新的列式文件格式(.pt 文件),3.10 及更早版本创建的集群在执行存储引擎升级前仍使用 Parquet(见 InfluxDB 3 Enterprise 存储引擎文档)。GreptimeDB 的 SST 文件格式是 Apache Parquet。
因此这次测试里有两组对比:同样使用 Parquet 的 GreptimeDB 与 InfluxDB 3 Core,以及 GreptimeDB 与改用私有格式的 InfluxDB 3 Enterprise。
测试结论
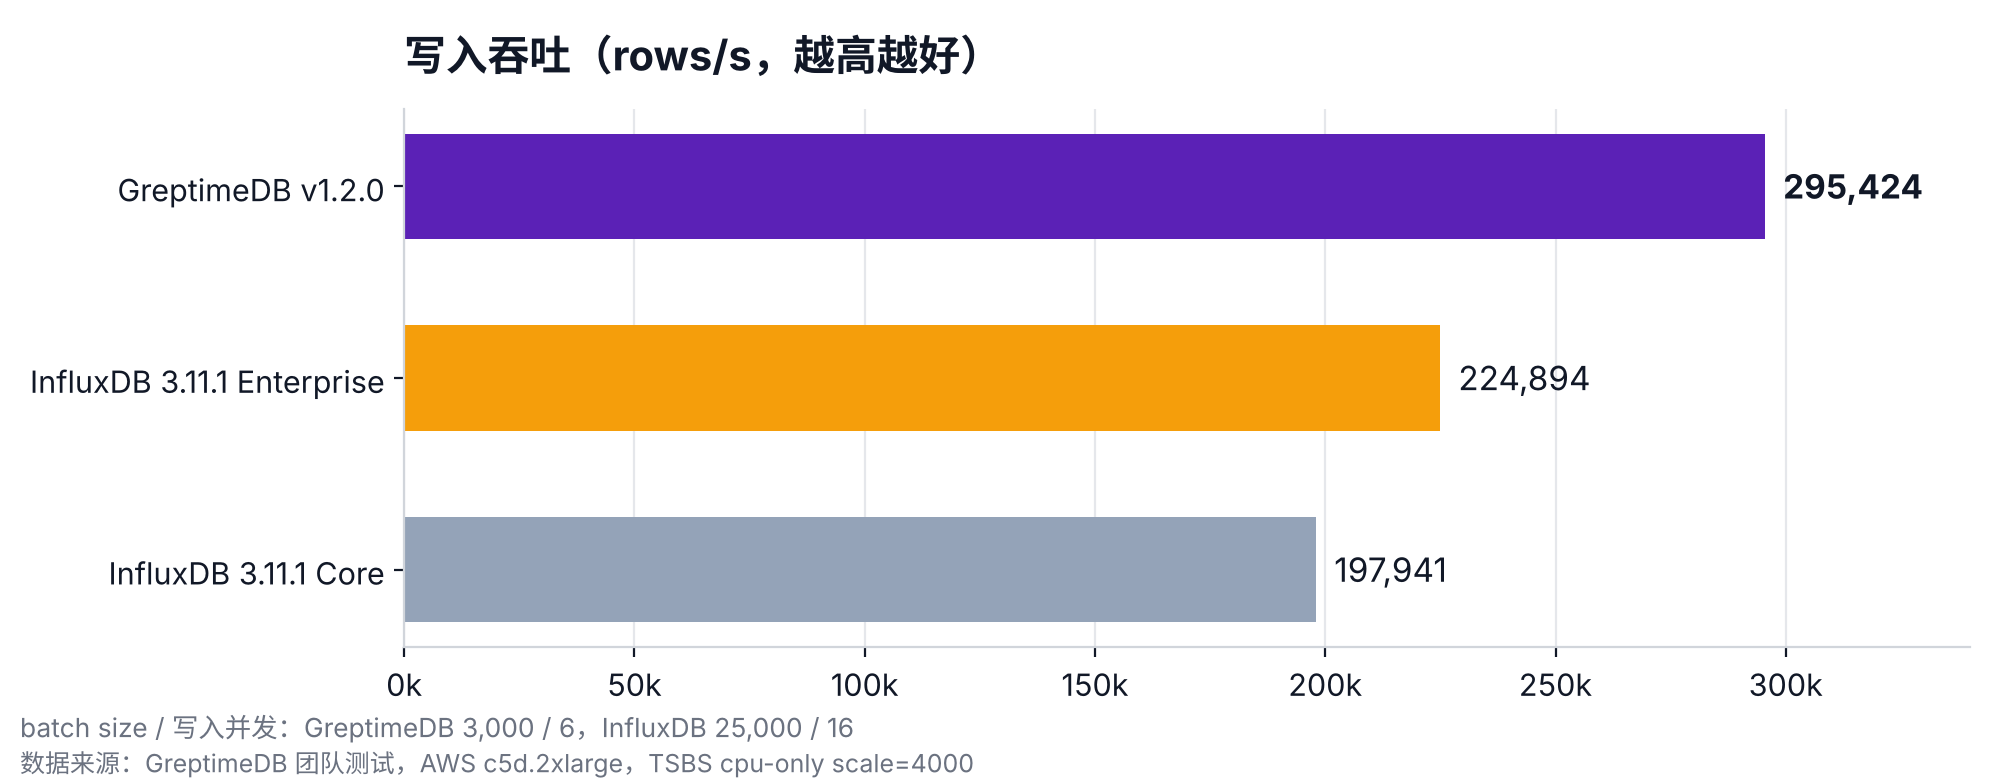
- GreptimeDB 的写入吞吐为 295,424 rows/s,是 InfluxDB 3 Enterprise 的 1.31 倍、InfluxDB 3 Core 的 1.49 倍。InfluxDB 使用了更大的 batch size 和更高的写入并发。
- 查询方面,GreptimeDB 与 Enterprise 互有优势。只涉及 1 台或 8 台主机的 9 类查询,Enterprise 更快,两者耗时都在几十毫秒以内;涉及全部主机的分组聚合、排序和 lastpoint 查询,GreptimeDB 更快,执行一次手动 compaction 后,lastpoint 的耗时约为 Enterprise 的 1/10。
- 同样使用 Parquet 的 InfluxDB 3 Core 在 13 类查询上慢于 GreptimeDB,另外 groupby-orderby-limit 和 lastpoint 两类查询出现 OOM。
- 写入完成后的磁盘占用:Enterprise 的总占用为 1.3 GB;GreptimeDB 的 SST 文件约 850 MB,另有 1.5 GB WAL;Core 的主要占用是 12 GB 的 WAL。
测试环境
| 项目 | 详情 |
|---|---|
| 机器规格 | AWS c5d.2xlarge(8 核 CPU,16 GB 内存) |
| 操作系统 | Ubuntu 24.04 LTS |
| 存储 | 300 GB gp3 |
| 软件版本 | TSBS(GreptimeTeam/tsbs) InfluxDB v3.11.1 Core InfluxDB v3.11.1 Enterprise GreptimeDB v1.2.0 |
| 测试数据集 | cpu-only,scale=4000 时间范围 2023-06-11 至 2023-06-14 采样间隔 10s |
三个数据库都使用本地文件存储,一次只运行一个数据库。
测试数据与查询
数据由 TSBS 的 cpu-only 场景生成,只有一张 cpu 表,包含 10 个 tag 和 10 个 field。scale=4000 表示模拟 4000 台主机,3 天、每 10 秒一个采样点,总写入行数为 103,680,000,总写入 metrics 数为 1,036,800,000。数据集以 influx 格式、不压缩的方式生成一次,三个数据库使用同一份数据。
查询使用 TSBS 的完整查询集,共 15 类:
| 查询 | 说明 |
|---|---|
| single-groupby-1-1-1 | 1 台主机的 1 个指标,按 5 分钟取 MAX,时间范围 1 小时 |
| single-groupby-1-1-12 | 1 台主机的 1 个指标,按 5 分钟取 MAX,时间范围 12 小时 |
| single-groupby-1-8-1 | 8 台主机的 1 个指标,按 5 分钟取 MAX,时间范围 1 小时 |
| single-groupby-5-1-1 | 1 台主机的 5 个指标,按 5 分钟取 MAX,时间范围 1 小时 |
| single-groupby-5-1-12 | 1 台主机的 5 个指标,按 5 分钟取 MAX,时间范围 12 小时 |
| single-groupby-5-8-1 | 8 台主机的 5 个指标,按 5 分钟取 MAX,时间范围 1 小时 |
| cpu-max-all-1 | 1 台主机的全部 CPU 指标,按小时聚合 |
| cpu-max-all-8 | 8 台主机的全部 CPU 指标,按小时聚合 |
| double-groupby-1 | 全部主机的 1 个 CPU 指标,按主机和小时分组求平均,时间范围 24 小时 |
| double-groupby-5 | 同上,5 个 CPU 指标 |
| double-groupby-all | 同上,全部 10 个 CPU 指标 |
| high-cpu-1 | 1 台主机中指标超过阈值的记录 |
| high-cpu-all | 全部主机中指标超过阈值的记录 |
| lastpoint | 每台主机最新的一条记录 |
| groupby-orderby-limit | 随机选取一个时间点,返回此前最近 5 个时间窗口的聚合结果 |
写入性能
| 数据库 | 写入吞吐(rows/s) |
|---|---|
| InfluxDB v3.11.1 Core | 197,941 |
| InfluxDB v3.11.1 Enterprise | 224,894 |
| GreptimeDB v1.2.0 | 295,424 |
GreptimeDB 与 InfluxDB 的写入参数不同。GreptimeDB 的 batch size 为 3,000,写入并发为 6。InfluxDB 3 保持持久化写入确认,不启用 no-sync 或 accept-partial,在这种同步模式下,一次写入请求默认约 1s 才返回。使用与 GreptimeDB 相同的参数时,InfluxDB 的写入速率只有 18,000 rows/s。为了测到 InfluxDB 的最大写入吞吐,我们把它的 batch size 调到 25,000、写入并发调到 16,单次写入的延迟仍然在 1s 左右。
在这组参数下,GreptimeDB 以更小的 batch 和更低的并发,写入吞吐比 Enterprise 高 31%,比 Core 高 49%。
查询性能
数据导入完成后,我们对三个数据库分别执行查询测试,query workers 为 1,每类查询执行多次取平均值,单位为 ms。GreptimeDB 另外测了一组执行一次手动 compaction 之后的结果,操作是在原数据库上依次执行:
sql
ADMIN FLUSH_TABLE('cpu');
ADMIN COMPACT_TABLE('cpu', 'swcs', 'window=7200');
window=7200 表示按 2 小时的数据窗口做 SWCS 压缩,语法见 GreptimeDB compaction 文档。
| 查询 | InfluxDB v3.11.1 Enterprise | InfluxDB v3.11.1 Core | GreptimeDB v1.2.0 | GreptimeDB v1.2.0(手动 compaction 后) |
|---|---|---|---|---|
| cpu-max-all-1 | 10.259 | 538.225 | 24.115 | 12.997 |
| cpu-max-all-8 | 19.887 | 576.350 | 54.490 | 31.760 |
| double-groupby-1 | 1013.684 | 4089.292 | 564.054 | 298.371 |
| double-groupby-5 | 1780.882 | 4308.885 | 776.175 | 446.186 |
| double-groupby-all | 2779.030 | 4602.828 | 1060.180 | 638.032 |
| groupby-orderby-limit | 1235.763 | OOM | 704.118 | 410.691 |
| high-cpu-1 | 3.959 | 823.497 | 17.540 | 13.378 |
| high-cpu-all | 4384.166 | 6747.910 | 4633.307 | 4171.391 |
| lastpoint | 9347.123 | OOM | 2585.120 | 946.952 |
| single-groupby-1-1-1 | 3.628 | 58.032 | 7.483 | 5.881 |
| single-groupby-1-1-12 | 4.337 | 705.723 | 13.051 | 10.058 |
| single-groupby-1-8-1 | 5.945 | 69.245 | 16.568 | 10.687 |
| single-groupby-5-1-1 | 4.475 | 61.952 | 8.088 | 6.649 |
| single-groupby-5-1-12 | 5.846 | 717.083 | 13.816 | 11.479 |
| single-groupby-5-8-1 | 7.543 | 69.285 | 17.883 | 11.839 |
按查询覆盖的主机范围,结果分成两组。
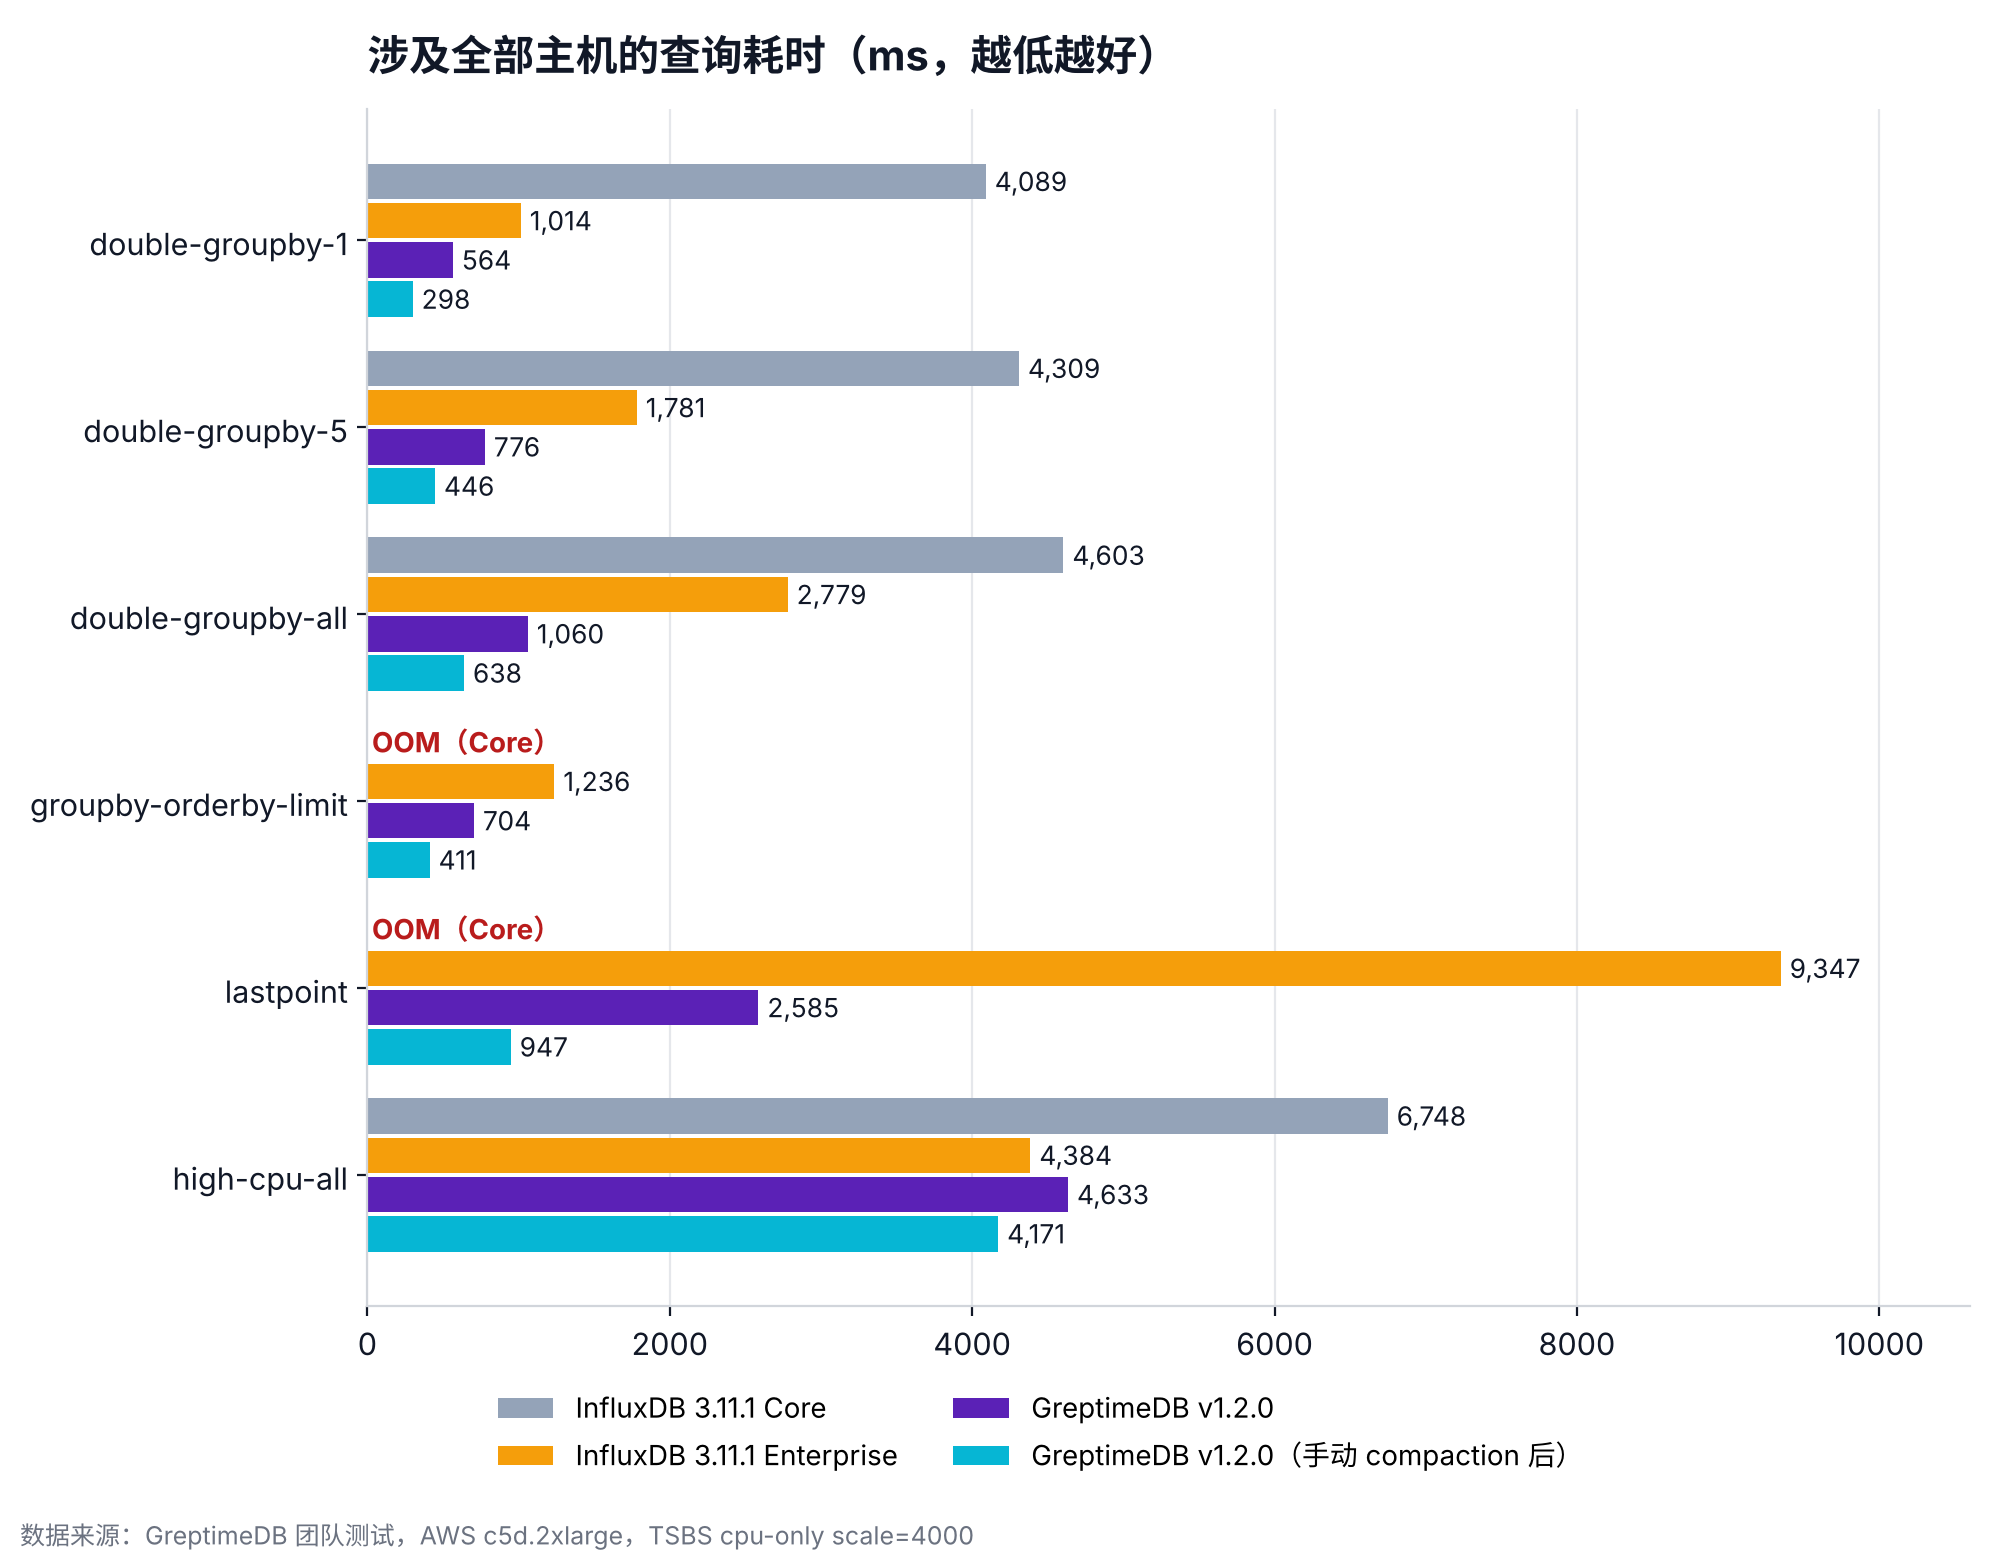
涉及全部主机的分组聚合、排序和 lastpoint 查询,GreptimeDB 比 Enterprise 快。导入完成后直接查询,GreptimeDB 快 1.8 到 3.6 倍;手动 compaction 后快 3.0 到 9.9 倍。差距最大的是 lastpoint:Enterprise 为 9347 ms,GreptimeDB compaction 后为 947 ms。high-cpu-all 两者接近,Enterprise 为 4384 ms,GreptimeDB compaction 前为 4633 ms、compaction 后为 4171 ms。
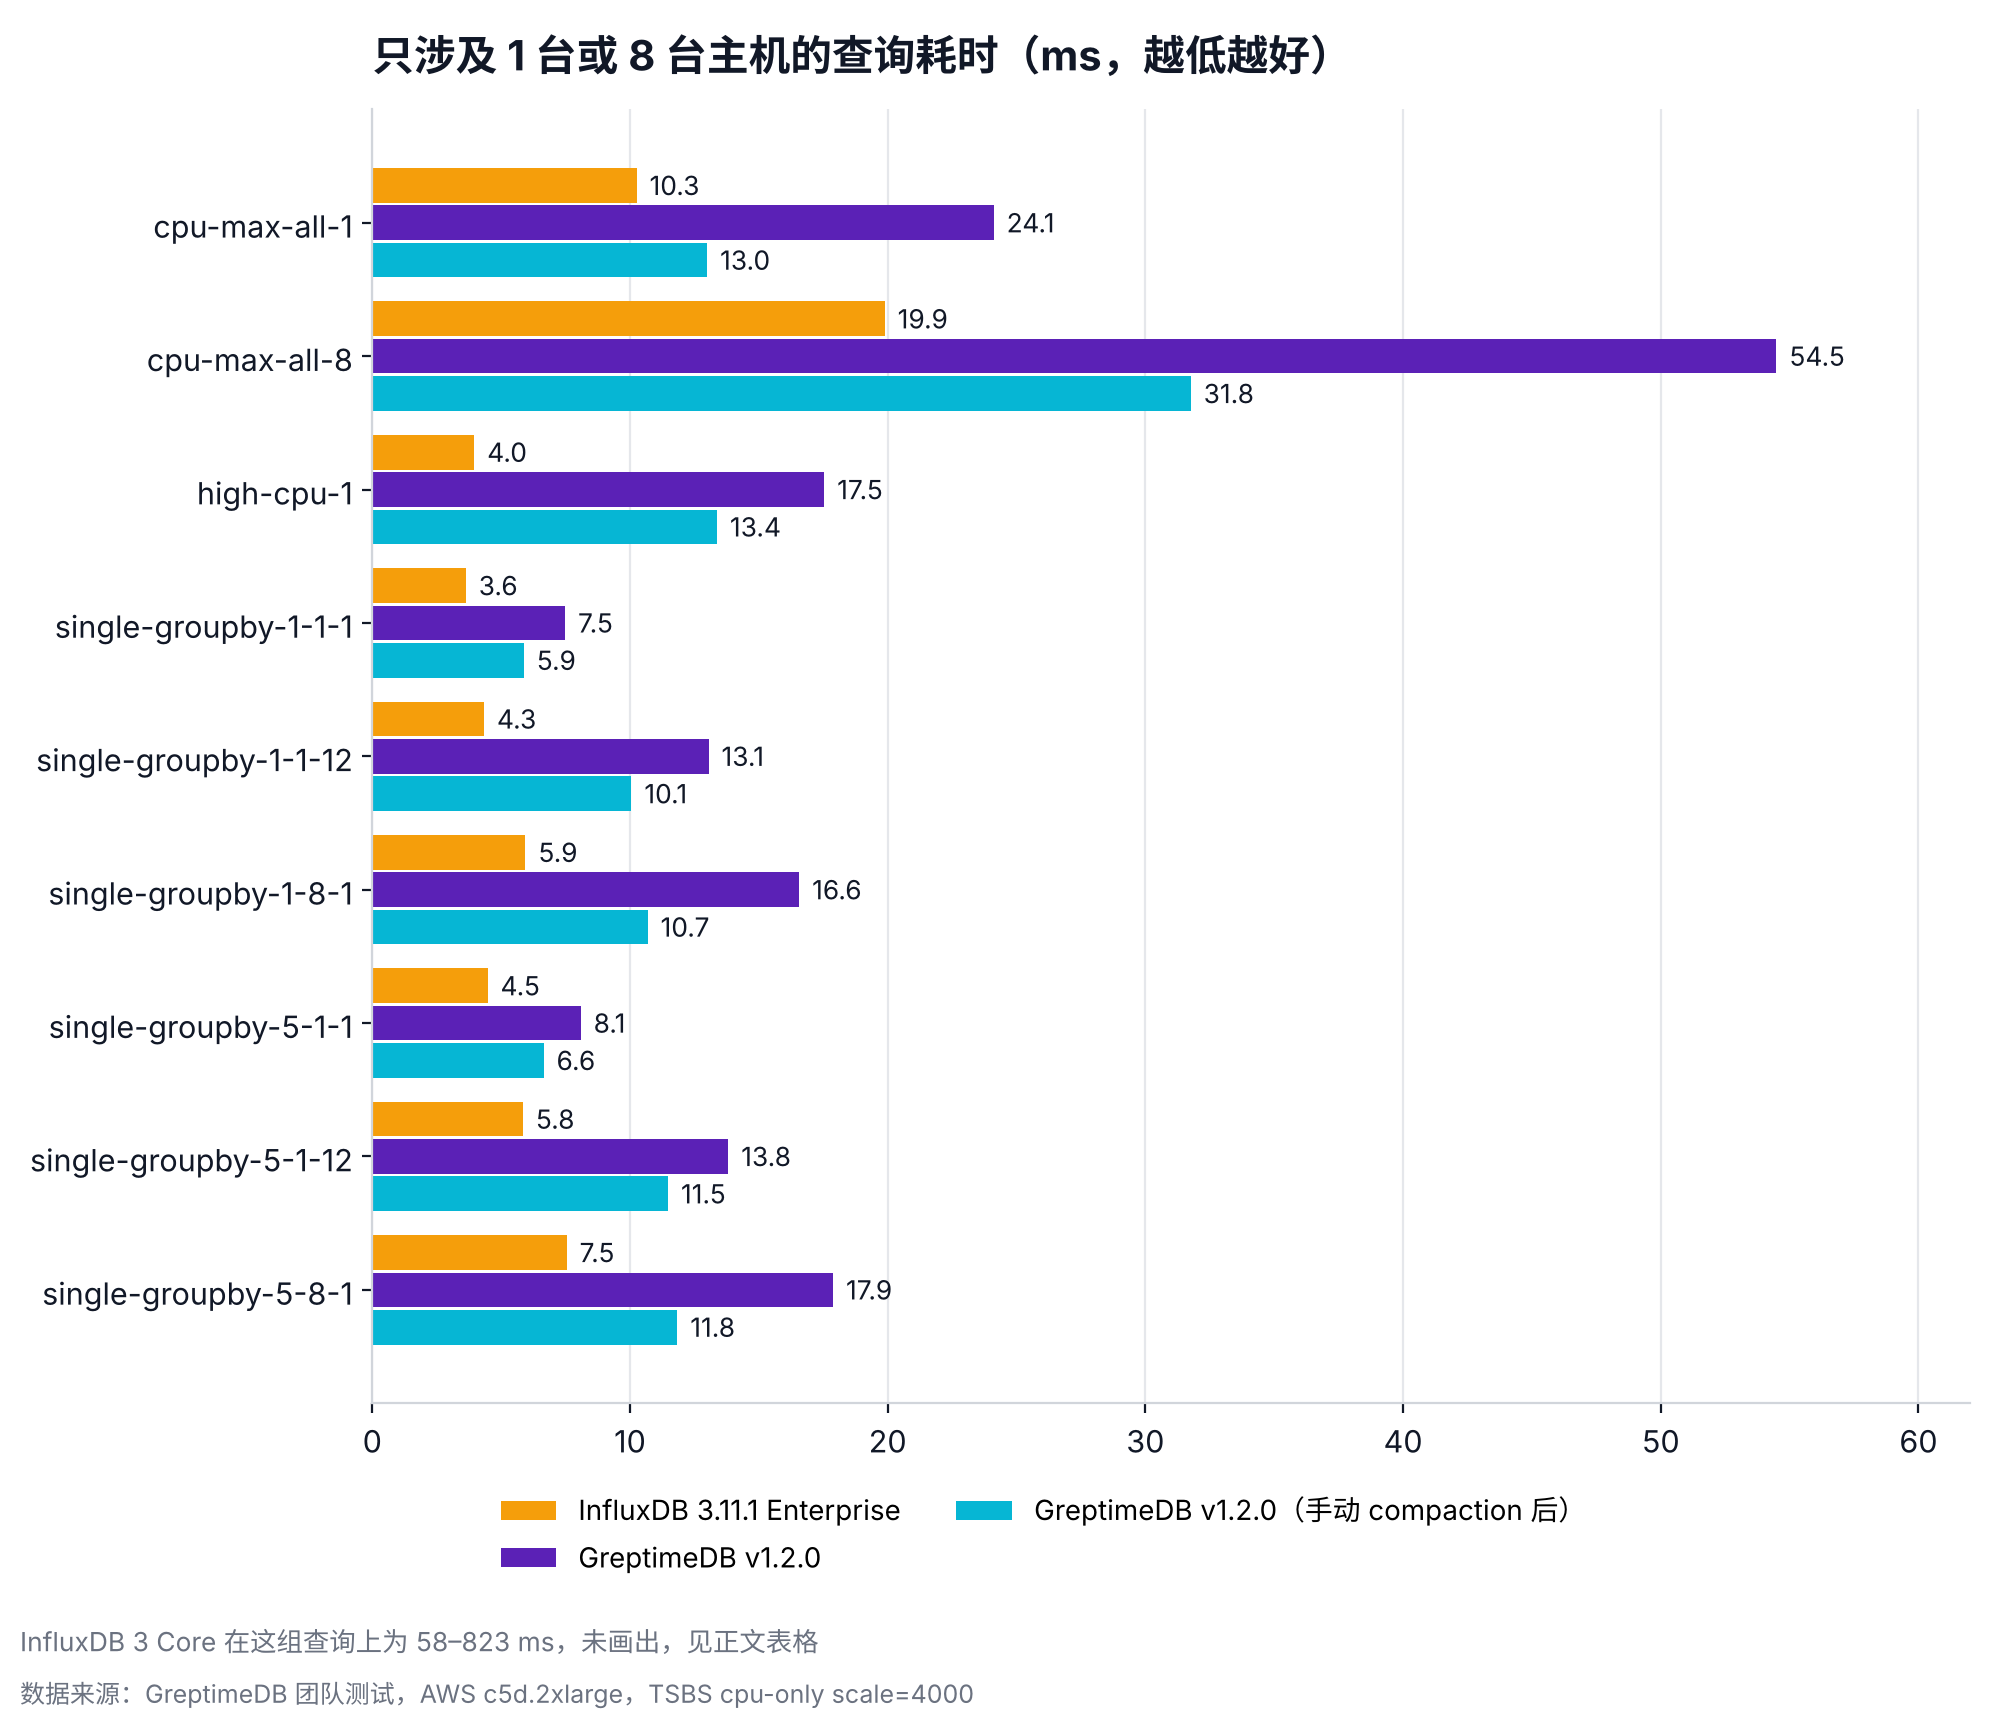
只涉及 1 台或 8 台主机的 9 类查询,Enterprise 更快:比 compaction 前的 GreptimeDB 快 1.8 到 4.4 倍,比 compaction 后快 1.3 到 3.4 倍。Enterprise 耗时 3.6 到 19.9 ms,GreptimeDB compaction 后为 5.9 到 31.8 ms。
两组差距的量级不同。Enterprise 在少量时间线查询上的领先,compaction 前最多 34.6 ms,compaction 后最多 11.9 ms;GreptimeDB 在全部主机查询上的领先从几百毫秒到几秒,lastpoint 在 compaction 后相差 8.4 s。
InfluxDB 3 Core 与 GreptimeDB 都把数据存为 Apache Parquet,但 Core 在 13 类查询上比 compaction 前的 GreptimeDB 慢 1.5 到 54 倍,另外 groupby-orderby-limit 和 lastpoint 两类出现 OOM。从这组数据看,使用开放的 Parquet 格式并不妨碍查询性能:GreptimeDB 在分组聚合、排序和 lastpoint 查询上快于 Enterprise;在少量时间线查询上 Enterprise 领先,绝对差距在 35 ms 以内。通过支持开放格式,GreptimeDB 企业版也兼容了 Apache Iceberg 数据湖格式(早期预览,见 GreptimeDB 企业版 26.05.1 发布)。
手动 compaction 让 GreptimeDB 的 15 类查询耗时降低了 10% 到 63%,降幅最大的是 lastpoint(2585 ms 降到 947 ms)。后续 GreptimeDB 会进一步优化实时写入下的 compaction 效果。
存储空间
写入完成后,我们停止进程,统计各数据库数据文件的占用:
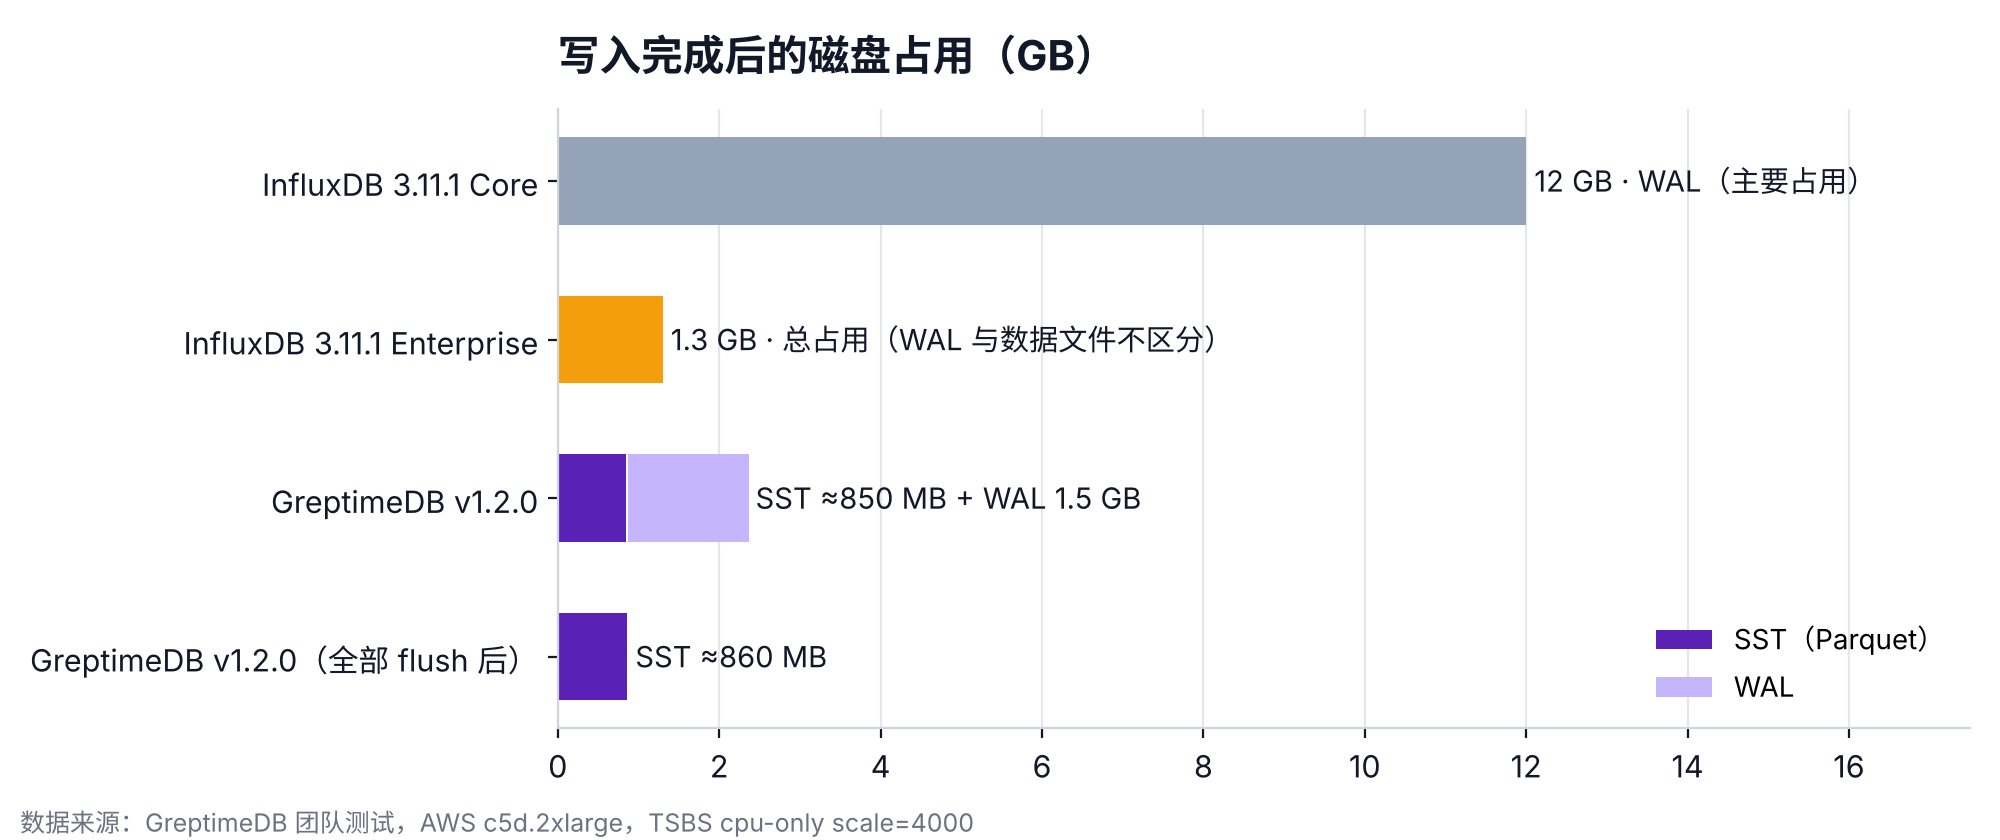
- InfluxDB v3.11.1 Core 的主要占用是 12 GB 的 WAL。
- InfluxDB v3.11.1 Enterprise 的 WAL 和其他数据文件使用同一种格式,不做区分,总占用为 1.3 GB。
- GreptimeDB 的 SST 文件(Apache Parquet)约 850 MB,WAL 为 1.5 GB。
把 GreptimeDB 的数据全部 flush 为 SST 文件后,SST 文件的占用约 860 MB。1,036,800,000 个 metrics 以 Parquet 格式存储后不到 1 GB。
复现方法
测试使用 Greptime 团队维护的 TSBS 仓库,仓库里提供了压测用的 skills。先克隆仓库:
bash
git clone https://github.com/GreptimeTeam/tsbs.git
cd tsbs
在 tsbs 目录中打开支持读取 .agents/skills 的编码助手(例如 Codex),按顺序发送下面的提示词,即可完成 GreptimeDB、InfluxDB 3 Core 和 Enterprise 的本地文件存储压测。可以根据测试需要调整提示词。
环境需要 Python 3。三个产品共同支持的原生平台为 Linux AMD64、Linux ARM64 和 macOS ARM64,Go 由环境 skill 检查或安装。
下面的提示词显式指定了 GreptimeDB 1.2.0、InfluxDB 3 Core 3.11.1 和 Enterprise 3.11.1,这些不是 skills 内置的默认版本。不指定版本时,setup skills 会在执行时解析 GreptimeDB 的最新稳定版或 InfluxDB 对应 edition 的官方最新版本;已有工作区不会自动升级。为便于复现,请明确指定版本。
1. 准备环境
text
使用 $setup-tsbs-environment 准备本仓库的 TSBS 构建环境,并确认所选 Go 工具链可用。2. 准备三个数据库
text
使用 $setup-greptimedb 和 $setup-influxdb3,准备以下独立的 managed 数据库工作区,均使用本地文件存储:
- GreptimeDB v1.2.0,database-id 为 greptime-120-manual。
- InfluxDB 3 Core 3.11.1,database-id 为 core-3111-manual。
- InfluxDB 3 Enterprise 3.11.1,database-id 为 enterprise-3111-manual。
确认实际安装的版本和工作区路径。按 $setup-influxdb3 的流程引导我在本地完成 Enterprise 许可证激活;需要邮件验证时提醒我,不要将许可证内容写入对话。
3. 生成一次共享数据
text
使用 $generate-tsbs-data,以 manual profile、influx 格式和 compression=none(不压缩)生成共享数据集。
如果已有匹配的数据集则复用;执行 verify 校验,返回 dataset-id、数据路径和校验和。
后续三个数据库都使用这个数据集,不要分别生成。
4. 顺序执行压测
将 <DATASET_ID> 替换为上一步返回的 ID:
text
使用 $benchmark-greptimedb 和 $benchmark-influxdb3,依次对以下工作区执行 all 阶段的压测:
1. greptime-120-manual
2. core-3111-manual
3. enterprise-3111-manual

三个数据库都显式绑定 dataset-id <DATASET_ID>,使用 manual profile、compression=none(不压缩)、完整查询集及默认查询次数,query workers 为 1。
保留各 skill 的默认写入参数;InfluxDB 保持持久化写入确认和整批拒绝策略,不启用 no-sync 或 accept-partial。
每个数据库使用独立的运行目录,一次只运行一个数据库。复用已成功加载的匹配数据,避免重复写入。
完成后返回各自的运行目录和成功或失败状态;失败时保留并指出诊断日志路径。
当前 manual profile 的写入默认值为:GreptimeDB 使用 6 workers、每批 3,000 行;InfluxDB 3 Core 和 Enterprise 使用 16 workers、每批 25,000 行。完整查询集包含 15 类查询。比较结果时需留意这些写入参数差异。
结果保存在各次运行目录的 summary.md 和 summary.json 中,默认运行根目录为 .benchmarks/greptimedb/runs/ 和 .benchmarks/influxdb3/runs/。
5. GreptimeDB 手动 compaction 后复测查询
完成第 4 步后,可以在原 GreptimeDB 数据库上执行一次手动 compaction,再复测查询。这里的 2 小时是数据窗口大小,不是压测时长;compaction 会原地整理已导入的数据。compaction 通过管理 SQL 执行,查询复测使用 benchmark skill 的 query 阶段。
将 <DATASET_ID> 替换为第 3 步返回的 ID:
text
对已完成压测的 greptime-120-manual 工作区执行 2 小时窗口的 SWCS 手动压缩,然后重新运行查询压测。

复用原工作区绑定的数据库、GreptimeDB 版本、配置和数据目录。在持有工作区锁、没有其他进程使用该工作区的情况下启动原实例,确认已导入的 cpu 表,并在该表所属数据库中依次执行:
ADMIN FLUSH_TABLE('cpu');
ADMIN COMPACT_TABLE('cpu', 'swcs', 'window=7200');
使用默认压缩并行度。结合执行结果和日志确认压缩成功完成后,正常停止实例并释放工作区锁,保留操作结果和日志。失败或无法确认完成时,停止后续复测并报告原因。

随后使用 $benchmark-greptimedb 的 query 阶段复测 greptime-120-manual,显式绑定 dataset-id <DATASET_ID>,复用第 4 步的查询集,保持 manual profile、compression=none、完整查询类型及默认次数、query workers 为 1。
直接使用原数据库中的数据,不重新生成或导入数据,不重置数据库或创建数据库副本。
为压缩后的查询测量创建新的运行目录,保留压缩前的结果。完成后返回复测结果目录、执行状态和压缩日志路径。
使用其他版本
可以直接替换第 2 步中的版本和工作区 ID,并在第 4 步使用相应的新 ID;如需执行第 5 步,也同步替换其中的 GreptimeDB 工作区 ID。也可以发送下面的提示词:
text
将 GreptimeDB 版本改为 <GREPTIME_VERSION>,InfluxDB 3 Core 改为 <CORE_VERSION>,Enterprise 改为 <ENTERPRISE_VERSION>。
使用对应 setup skills 安装指定版本,为每个产品的新版本创建独立工作区,复用 dataset-id <DATASET_ID>,然后按上述相同参数顺序运行 manual 压测。
记录实际运行版本;如果指定版本缺少受支持平台的发行包或校验文件,或无法兼容当前压测流程,请报告原因,不要自动换成其他版本。
参考链接
- TSBS:https://github.com/GreptimeTeam/tsbs
- GreptimeDB compaction 文档:https://docs.greptime.cn/user-guide/deployments-administration/manage-data/compaction/#严格窗口压缩策略swcs和手动压缩
- InfluxDB 3 Enterprise 存储引擎文档:https://docs.influxdata.com/influxdb3/enterprise/reference/internals/storage-engine/
- GreptimeDB vs. InfluxDB 性能测试报告(2024):https://greptime.cn/blogs/2024-08-08-report


