
本页内容
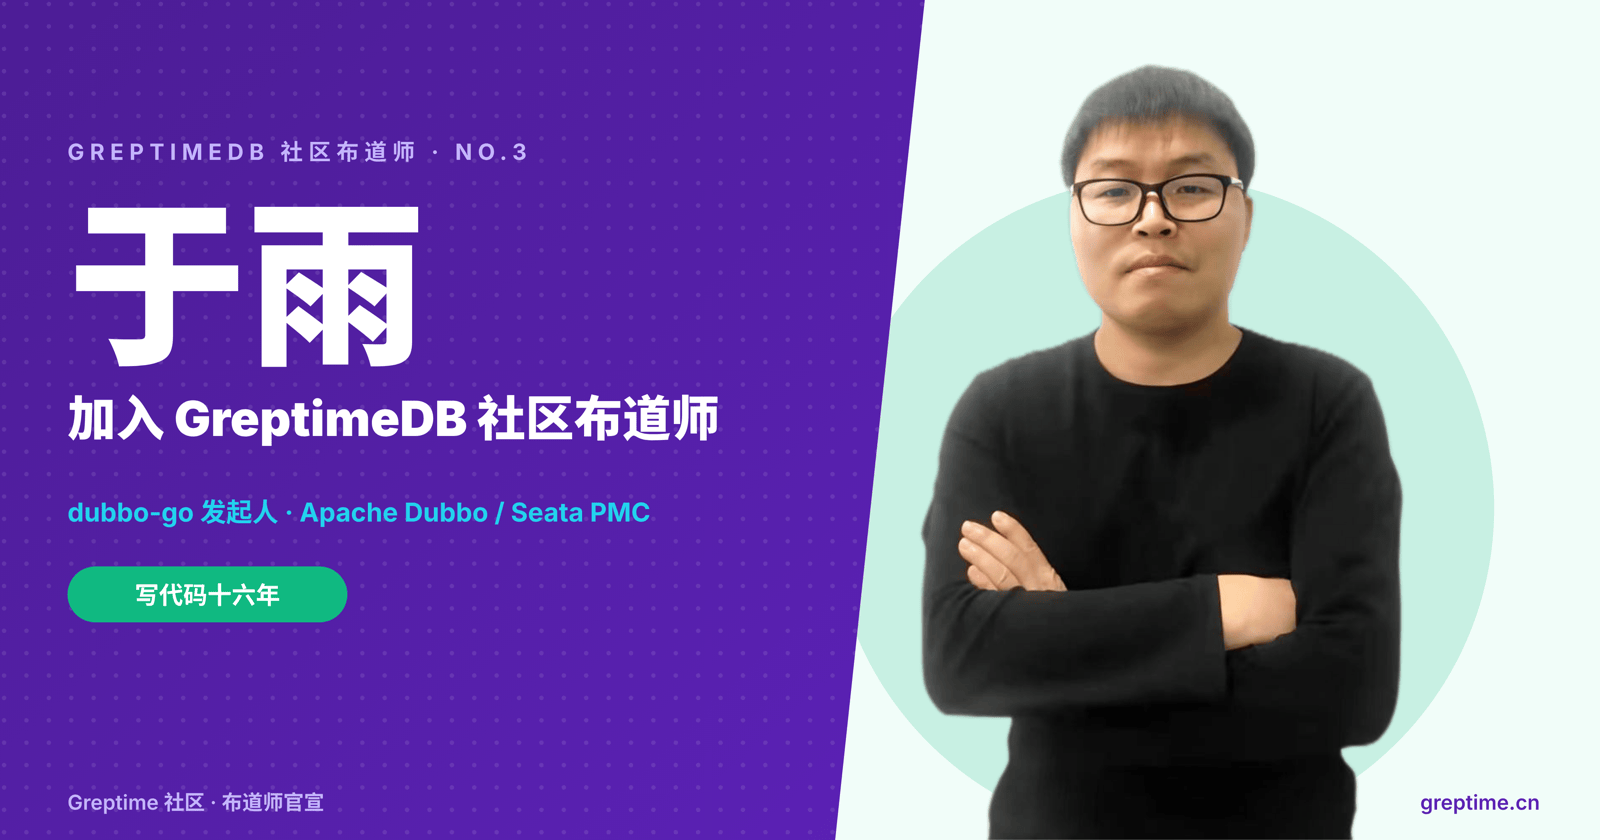
编者按:GreptimeDB 很荣幸地官宣于雨(GitHub @AlexStocks)为社区第三位布道师。于雨 2016 年发起 dubbo-go,是 Apache Dubbo 和 Seata PMC,也负责过 OpenAtom PikiwiDB(原 Pika)。
“于雨”是我在开源圈的名号,GitHub 上叫 AlexStocks。这个名字是我 2012 年用微信时随手起的,后来入职阿里继续当花名,用久了就成了常用名。
我从 2015 年开始给 Redis 贡献代码,2016 年发起 dubbo-go,到现在已经十年,是 Apache Dubbo 和 Seata PMC。后来还负责过 OpenAtom PikiwiDB,也就是原来的 Pika。
这些年,我在 QCon、DTCC、GopherChina、ApacheCon、GIAC 等技术活动上做过 30 多场分享,也在自己运营的 dubbogo 社区公众号里写过 300 多篇文章。
我曾获得阿里 2021 年开源先锋人物、开放原子 2022 年度开源贡献之星、中国科学技术协会 2022 年“科创中国”创新项目奖、信通院 2022 年 OSCAR 尖峰开源人物等荣誉,也曾担任阿里开源大使。CSDN“2023 年度创新产品与解决方案”、OSCHINA“2023 年度优秀开源技术团队”等荣誉,也与我长期参与的开源项目有关。这些荣誉和经历,都是我参与 Dubbo、Seata、Pika 等项目,一点点做出来、积累下来的。
我跟 GreptimeDB 的缘分,要从 2023 年 10 月 28 日那场 Meetup 说起。
那天在北京海淀中关村创业大街,GreptimeDB、KubeBlocks 和 Pika 做了一场联合活动,主题是《云原生时代下的数据库新趋势》。那是我第一次在线下接触 GreptimeDB。
当时项目开源还不到一年,刚经历过发布后的热度。到那次活动前后,已经有两千七百多颗 star 和近百个外部 PR。
三年过去,GreptimeDB 已经进入 1.x 阶段。截至 2026 年 9 月 20 日,GitHub star 六千六百多,贡献者 140 多人。
数字在增长,我更看重的是这三年它怎么走过来。
我认可 GreptimeDB,有三个原因。
第一,他们在解决真实的问题。
GreptimeDB 的核心团队长期做大型互联网公司的基础设施和可观测性系统,自己就是 Prometheus、Loki、ES 等多套系统的使用者。
我在蚂蚁待过四年,知道大规模监控系统意味着什么,也知道一个做过统一监控存储层的人,写代码时会考虑哪些问题。
GreptimeDB 的起点是几个长期被同一个问题困扰的人,决定重新做一套基础设施。
第二,他们的节奏很稳。
双周报持续更新,release notes 会把 PR 和修复项写清楚。v1.0 从 RC 到 GA 也磨了很长时间,直到认为产品可以进入生产环境,才正式发布。
做基础设施的人,通常不会急着把一个版本包装成“重大升级”。他们知道版本发布以后,真正的工作才开始:用户会部署,会压测,会遇到边界条件,也会把各种奇怪的业务流量和故障场景带进来。一个项目能不能长期走下去,看的就是这些事情有没有人持续处理。
第三,这条技术路线我认。
metrics、logs、traces 放进同一个引擎,Rust 做核心,对象存储承接数据,同时支持 SQL 和 PromQL,这些选择背后都是很具体的工程问题。
我自己做过实时监控系统,也搭过稳定性体系,清楚把三套系统合成一套,省下的不只是机器成本。更现实的收益是,半夜出问题时,不用在三套 UI 之间来回切,也不用先花时间判断这个异常到底属于哪套系统。
AI 这一波,他们也没有停在“让 Agent 执行 SQL”。MCP Server、Agent Skills、只读和脱敏限制,以及基于 OpenTelemetry 的 AI 调用观测(见《GreptimeDB 为 AI Agent 时代做了什么》),说明 GreptimeDB 在把 Agent 的调用、成本、延迟和错误也纳入可观测体系。越来越多的业务由 Agent 发起和执行,这会是一个绕不开的问题。
国内开源圈这么多年一直不缺热闹:有人埋头做事,也有人更在意头衔、关系和资源。我看一个项目的标准一直很简单:看这帮人是不是真的在写代码。
GreptimeDB 这帮人是真的在写,也是真心在把产品做好。这是我愿意做 GreptimeDB 布道师的原因。
欢迎于雨加入 GreptimeDB 社区布道师团队!也欢迎更多对可观测性和数据库感兴趣的朋友加入,布道师计划的权益和申请条件见 2025 年 2 月 19 日的双周报。


